技术能力
把智能体框住的四件事
大模型的随机性消除不掉,模型的自觉也靠不住。我们用中间件、提示词约束与检索机制把行为框住:成本可控、依据不漂、每句有出处、首字秒回。这是专业团队与套壳 demo 的差别。
01
省钱 · 聊得再久,成本可控
回答成本 = 输入 token × 轮次。我们从两头一起掐。
- 旧轮次工具结果自动裁剪 每一轮检索、搜索产生的大段工具输出,在下一轮用户提问后自动替换为一行占位符,当前轮的调用链完整保留。工具结果是长对话里最占 token 的部分,裁掉它等于砍掉大头。
- 超阈值自动摘要压缩 对话超过 token 或消息条数阈值,系统自动把早期历史提炼为「会话目标 / 关键结论 / 待办」的结构化摘要,只保留最近消息——记忆还在,体积不涨。
- 回答长度软约束 系统提示词明确要求「给到足够上下文后即停止,简洁但不生硬」,避免模型注水凑字数。
用户用得越多、聊得越久,单轮成本曲线是平缓的。
02
稳定 · 同一个问题,同一套答案依据
答案可以不随模型漂移,只要它锚在别的东西上。
- 答案锚定知识库 回答前先检索客户自有语料(RAG),答的是入库的原文依据。语料不变,答案的依据就不变,不因模型版本、时段或措辞而漂移。
- 人设与价值观约束 口吻与价值取向写进约束,第 1 次问和第 100 次问,面对的是同一个角色。
- 会话状态持久化 对话历史写入数据库,中途断线重连、换设备追问,上下文不断片。
同一个问题问一百次,依据和口吻都是同一套。
03
准确 · 每句话都有出处
这是最硬的一条:引用由系统强制,落在它支撑的那句话上。
- 检索与生成分工 检索环节用专业 embedding 模型加问题重写,把语料与问题映射到同一语义空间,同义不同词也能精准召回;生成环节由大模型把召回片段融合、提炼、组织成答。检索管「找得准」,模型管「答得好」。
- 来源标识随片段带出 每条召回片段都标注来源文件名、页码、置信分与原文档路径。
- 提示词强制内联引用 系统明确要求使用 [1][2] 内联引用、禁止在末尾罗列来源——引用必须落在它支撑的那句话上。
- 可溯源闭环 客户看到 [2],就能回到知识库第 2 号来源文档核对原文;答错了,能定位到是哪份语料的问题。
答错可以查到源头,这是系统能被长期信任的前提。
04
快速 · 首字秒回,长答不干等
体感速度取决于首字延迟,不取决于总时长。
- WebSocket 流式输出 答案逐字上屏,第一个字秒级出现。
- 秒级语义检索 向量检索在数据库内完成,Top-10 相关片段秒级召回,不多一跳外部检索服务。
- 工作流过程可见 前端实时展示「正在检索知识库 / 正在生成答案」,用户看得见系统在干活,而不是对着黑箱等待。过程透明本身也是对「答之有据」最直观的演示。
- 模型选型是配置项 模型供应商与型号都是配置项,追求极致响应时可一键切换,不动代码。
等待被拆成看得见的步骤,焦虑就少了一半。
这两张截图里能看到什么
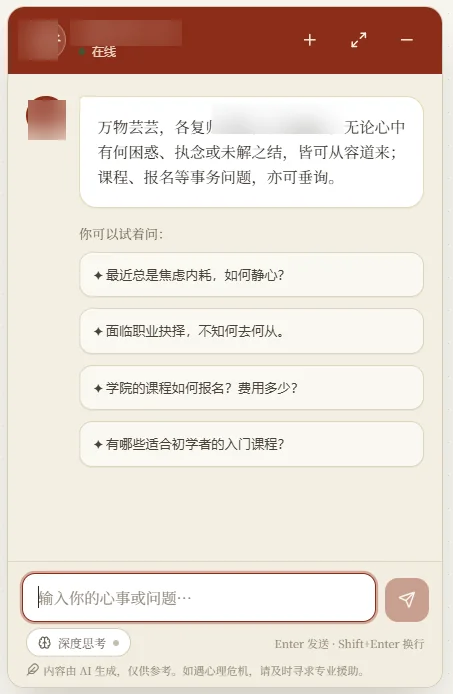
入口就是约束:同一副口吻,同一条安全边界
人设与价值取向写进系统约束,引导问句把第一个问题带进智能体答得了的范围。
页脚常驻「内容由 AI 生成,仅供参考」与危机求助提示——边界放在用户看得见的地方。
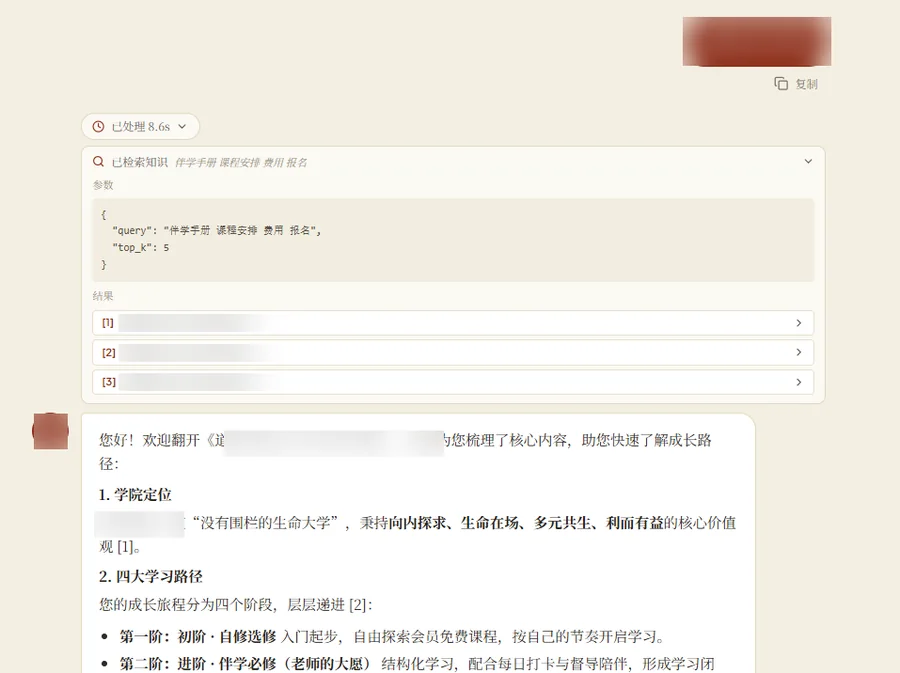
检索过程摊开给你看,引用落在句子上
界面实时显示这一次检索的参数(query 与 top_k = 5)与召回的来源文档,回答里的 [1][2] 指回对应来源。
答案可核对;答错了,能定位到是哪份语料的问题。「已处理 8.6s」是这一次完整作答的耗时,过程中每一步用户都看得见。
客户品牌信息已在截图中做脱敏处理。
一张表看完
| 能力 | 我们做了什么 | 对客户意味着什么 |
|---|---|---|
| 省钱 | 双层上下文压缩(工具结果裁剪 + 历史摘要)加简洁性提示词约束 | 聊得再久,token 成本可控 |
| 稳定 | 答案锚定自有知识库,加人设约束与会话状态持久化 | 同一问题始终同一套依据、同一副口吻 |
| 准确 | 检索与生成分工,强制内联引用 [1][2],带来源文件与置信分 | 每句话有出处,答错能查到源文档 |
| 快速 | WebSocket 逐字流式输出 + 库内向量检索 + 模型可切换 | 首字秒回,长答不干等 |
以上机制在一个面向文化教育机构的问答智能体项目中落地运行,同一套底座已复用于高校行政与医院院外管理场景。具体实现细节不在本页展开。